Leserlichkeit von Handschrift mit Foundation Modellen einordnen: Unsere Forschung in Scientific Reports veröffentlicht
Hintergrund und Motivation
Leserlichkeit beschreibt, wie deutlich sich Buchstaben und Wörter lesen lassen, und ist das sichtbare Ergebnis des Schreibprozesses. Schlecht leserliche Handschrift bei Kindern kann auf Schwierigkeiten in den zugrunde liegenden motorischen und kognitiven Prozessen sowie auf Entwicklungsstörungen hinweisen und hängt mit dem späteren Schulerfolg zusammen. Wer die betroffenen Kinder früh erkennt, kann sie gezielt fördern. Heute bewerten Lehrer, Wissenschaftler und Ergotherapeuten die Leserlichkeit mit Bewertungsskalen, was Zeit kostet und von der bewertenden Person abhängt. Es gibt automatisierte Systeme, viele davon setzen jedoch Grafiktabletts oder spezielle Stifte voraus, die die Schreibbewegung aufzeichnen, was ihren Einsatz einschränkt. Verfahren, die mit einem einfachen Bild der Handschrift arbeiten, kommen ohne diese Voraussetzung aus, sind für alphabetische Schriften aber noch selten, unter anderem weil Leserlichkeit subjektiv ist und annotierte Daten knapp sind.
Unser Ansatz: Paarvergleiche und ein Foundation Modell
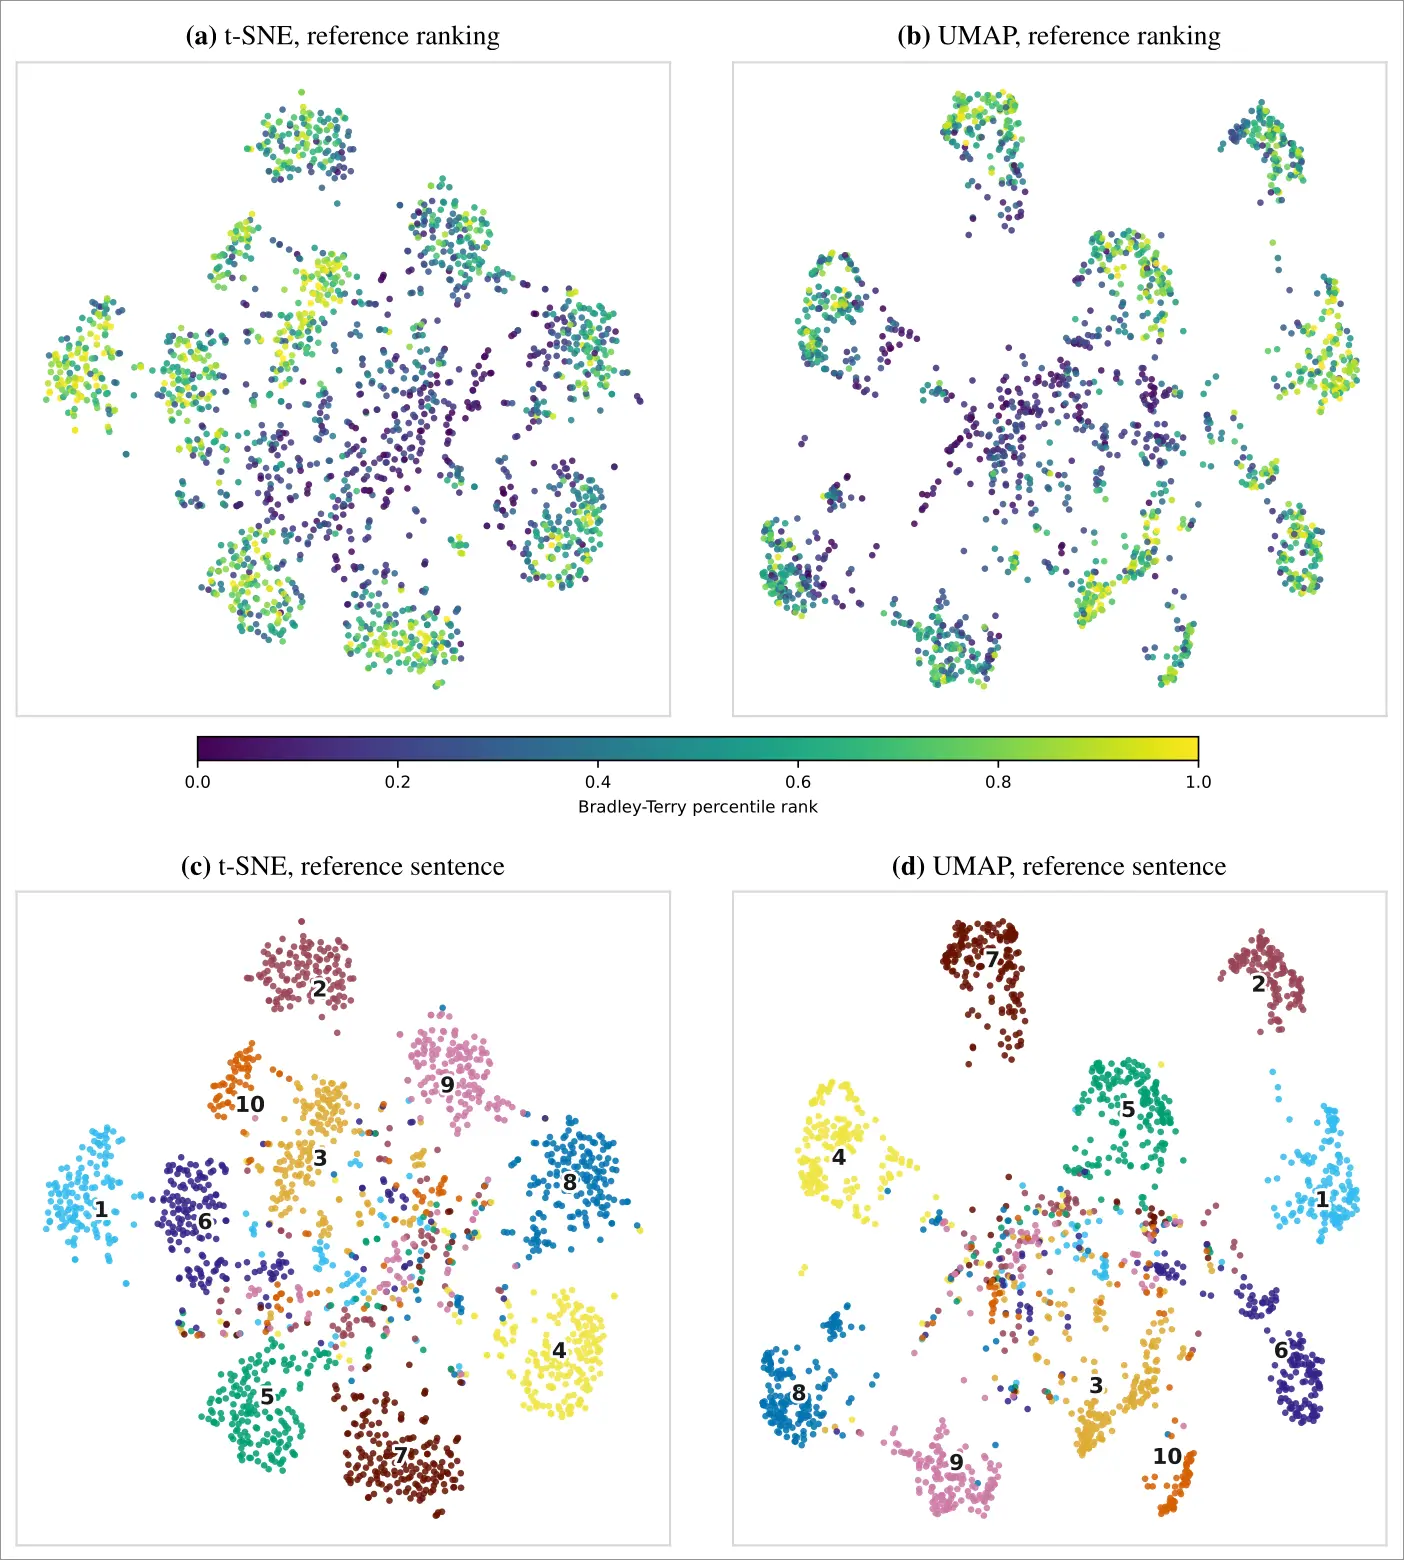
Die Arbeit entstand mit der Masterstudentin Meike Bauer und dem Doktoranden Marco Lents als gleichberechtigten Erstautoren, gemeinsam mit dem Doktoranden Francesco Di Salvo, den Masterstudenten Erik Schmidt und Lukas Pieger, Professor Christian Ledig sowie unseren Partnern von STABILO und dem Schreibmotorik Institut. Im Jahr 2024 schrieben 202 Kinder im Alter von zehn bis zwölf Jahren an zwei Schulen in Deutschland dieselben zehn kurzen deutschen Sätze von Hand ab. Die eingescannten Proben bilden den Datensatz Handwriting Assessment for Legibility and Ordering (HaLO) mit 1.907 Bildern. Eine einzelne Probe auf einer absoluten Skala zu bewerten, ist für Menschen anspruchsvoll und führt zu verrauschten Bewertungen. Den Annotatoren wurden deshalb jeweils zwei Proben gezeigt, und sie wählten diejenige aus, die sich flüssiger lesen lässt. Acht Annotatoren trafen 19.070 solcher Paarvergleiche. Ein bayessches Bradley-Terry-Modell, ein statistisches Modell für Paarvergleiche, erzeugt daraus eine Referenzrangfolge aller Proben von der am wenigsten bis zur am besten leserlichen.
Für die automatische Bewertung durchläuft jedes Bild den eingefrorenen Bild-Encoder von Pixtral 12B, einem multimodalen Foundation Modell, das auf natürlichen Bildern und Dokumenten vortrainiert wurde. Der Encoder verarbeitet Bilder beliebiger Größe und beliebigen Seitenverhältnisses, sodass eine Zeile Handschrift nicht skaliert werden muss. Eine einzige lineare Schicht mit 1.025 Parametern, ein sogenannter Linear Probe, bildet die entstehende Bildrepräsentation auf einen Leserlichkeitswert ab. Sie wird auf den Paarvergleichen trainiert, und die Werte aller Proben ergeben zusammen eine Rangfolge, die sich mit der menschlichen Referenz vergleichen lässt.
Ergebnisse
Auf dem Testdatensatz erkannte der Linear Probe in 83 Prozent der Fälle die leserlichere Probe eines Paares, bei einer Fläche unter der ROC-Kurve von 0,92. Da menschliche Urteile nicht vollständig konsistent sind, kann selbst ein Modell, das direkt an die Annotationen angepasst wird, nicht jedes Mal richtig liegen: Das Bradley-Terry-Modell erreicht 90 Prozent und eine Fläche unter der Kurve von 0,97, was die praktische Obergrenze für diesen Datensatz markiert. Tiefere Netzwerke auf denselben Repräsentationen brachten keine signifikante Verbesserung, und derselbe Linear Probe auf den Encodern CLIP und DINOv2 erreichte niedrigere Werte von 0,87 und 0,89.
Die Rangfolge des Modells stimmt so eng mit der menschlichen Referenzrangfolge überein, wie die Rangfolgen zweier menschlicher Bewerter miteinander übereinstimmen: Kendalls Tau von 0,70 und Spearmans Rho von 0,89 für das Modell, gegenüber durchschnittlich 0,71 und 0,89 zwischen Menschen. Als vier Annotatoren Proben auf einer Fünf-Punkte-Skala bewerteten, lag ihre Übereinstimmung untereinander zwischen 0,45 und 0,66 (Krippendorffs Alpha), ihre Übereinstimmung mit dem Modell dagegen zwischen 0,61 und 0,70. Das Modell erreicht damit bei der Rangfolge die Konsistenz menschlicher Bewerter und erreicht oder übertrifft sie bei einzelnen Bewertungen. Eine Analyse des Repräsentationsraums des Encoders zeigt zudem, dass Eigenschaften wie Schreibschrift und dünne Striche darin linear kodiert sind und dass in Schreibschrift verfasste Proben tendenziell niedrigere Leserlichkeitswerte erhalten. Die Bildrepräsentationen, die Annotationen und der Code sind unter der MIT-Lizenz öffentlich verfügbar.
Die vollständige Abhandlung finden Sie hier. Den Datensatz finden Sie hier und den Code hier.
Über Scientific Reports
Scientific Reports ist eine Open-Access-Zeitschrift des Nature Portfolio, die Forschung aus den Naturwissenschaften, der Psychologie, der Medizin und den Ingenieurwissenschaften veröffentlicht. Laut den Journal Citation Reports 2025 hat sie einen Zwei-Jahres-Impact-Factor von 4,9 und ist mit mehr als 1.061.414 Zitationen im Jahr 2025 die am zweithäufigsten zitierte Fachzeitschrift der Welt. Da die Publikation frei zugänglich ist, können Lehrer, Therapeuten und Wissenschaftler sie ohne Abonnement lesen.
Von drei Masterarbeiten zu einer Publikation
Die Publikation ist das Ergebnis von drei aufeinander aufbauenden Masterarbeiten an unserem Lehrstuhl, die alle von Professor Christian Ledig betreut wurden. Erik Schmidt und Lukas Pieger legten gemeinsam das Fundament. In enger Zusammenarbeit mit STABILO entwickelten sie einen standardisierten Schreibtest und ein Bewertungswerkzeug und erhoben die Handschrift der Kinder mit dem STABILO DigiPen, einem Kugelschreiber mit Bewegungssensoren, der auf gewöhnlichem Papier schreibt. Das Ergebnis war eine erste Version des Datensatzes mit absoluten Leserlichkeitsbewertungen.
In seiner Arbeit "Deep Learning based Evaluation of Handwriting Legibility using a Sensor Enhanced Ballpoint Pen" untersuchte Erik Schmidt, ob sich die Leserlichkeit aus den Sensordaten des Stifts bestimmen lässt. Seine Modelle passten sich zu stark an die Trainingsdaten an und stützten sich vor allem darauf, ob eine Probe in Schreibschrift oder in Druckschrift verfasst war. Das zeigte die Grenzen des sensorbasierten Ansatzes auf und wies auf den Schreibstil als starken Einflussfaktor der wahrgenommenen Leserlichkeit hin, einen Zusammenhang, den die Publikation später in den Repräsentationen des Foundation Modells bestätigt. Lukas Pieger verfolgte in seiner Arbeit "Deep Learning based Legibility Evaluation using Images of Children's Handwriting", die Jens Barth von STABILO als Zweitbetreuer begleitete, den bildbasierten Ansatz. Seine bildbasierten Modelle erzielten bei der allgemeinen Leserlichkeit vergleichbare Ergebnisse wie die sensorbasierten Modelle und bei spezifischeren Leserlichkeitsmerkmalen deutlich bessere. Zudem stellte er fest, dass sich die Bewertungen von Experten und Laien nicht signifikant unterschieden, während die Übereinstimmung zwischen den Bewertern gering blieb.
Meike Bauer machte diese geringe Übereinstimmung zum Ausgangspunkt ihrer Arbeit "Deep Learning Based Assessment of Handwriting Legibility via Pairwise Image Comparisons and Ranking". Sie annotierte die Handschriftproben mit Paarvergleichen neu, entwickelte das Verfahren zur Rangbildung mit dem Bradley-Terry-Modell und zeigte, dass Paarvergleiche deutlich konsistenter sind als absolute Bewertungen. Ihre Modelle erkannten bereits in bis zu 84 Prozent der Fälle die leserlichere Probe eines Paares. Gemeinsam mit Marco Lents, der das Modell weiter verbesserte, die abschließenden Experimente durchführte und das Manuskript mitverfasste, erweiterte sie ihre Arbeit zur veröffentlichten Publikation: den HaLO-Datensatz als öffentliche Ressource, die Abschätzung der Leistungsobergrenze, den Vergleich mit menschlichen Bewertern bei Rangfolgen und bei einzelnen Bewertungen, den Vergleich verschiedener Encoder und die Analyse des Repräsentationsraums. Nach ihrem Abschluss wechselte Meike Bauer zu PwC.
Forschung und Industrie im Zusammenspiel
Das Projekt ist eine Gemeinschaftsarbeit unseres Lehrstuhls, der STABILO International GmbH und des Schreibmotorik Institut e.V., beide mit Sitz in Heroldsberg. Tim Hamann und Jens Barth aus der digitalen Produktentwicklung von STABILO stellten den STABILO DigiPen bereit, wirkten am Studiendesign mit und erhoben die Handschriftproben gemeinsam mit unseren Studenten an den Schulen. Tal Hoffmann, Leiterin des Schreibmotorik Instituts, und Susanne Salata, Ergotherapeutin und wissenschaftliche Mitarbeiterin am Institut, brachten ihre Expertise zur Handschrift ein und begleiteten den wissenschaftlichen Hintergrund zur Leserlichkeit. Tal Hoffmann, Jens Barth und Susanne Salata wirkten zudem ehrenamtlich als Annotatoren an den Paarvergleichen in der Masterarbeit von Meike Bauer mit. Das Schreibmotorik Institut ist ein gemeinnütziges, außeruniversitäres Forschungsinstitut, das sich mit der Handschrift, ihrem Zusammenhang mit Lese- und Schreibkompetenzen und der Förderung von Kindern befasst, denen das Schreiben schwerfällt.
Jeder Partner brachte etwas ein, das die anderen allein nicht hätten leisten können. STABILO steuerte das Schreibgerät und die Erfahrung eines Unternehmens bei, das Produkte zum Schreiben entwickelt, das Schreibmotorik Institut das Wissen darüber, wie sich Handschrift entwickelt und wie sie in der Praxis bewertet wird, und unser Lehrstuhl die Methoden des maschinellen Lernens und die Studenten, die beides in Forschung umsetzten. Für die Studenten bedeutete das, vom ersten Tag ihrer Abschlussarbeit an einer realen Fragestellung mit realen Daten zu arbeiten und ihre Ergebnisse regelmäßig mit Partnern aus Industrie und Praxis zu diskutieren. Die Arbeit entstand im Rahmen des Projekts KIBEL, gefördert vom Bayerischen Staatsministerium für Wirtschaft, Landesentwicklung und Energie im Bayerischen Verbundforschungsprogramm, mit zusätzlicher Unterstützung durch die Hightech Agenda Bayern.
Im November 2025 berichtete TV Oberfranken über das Projekt, den Beitrag finden Sie hier.
Ausblick
Die Publikation benennt auch die nächsten Fragen: ob sich die Ergebnisse auf andere Sprachen, Schriften und Altersgruppen übertragen lassen, ob Texterkennungssoftware an denselben Proben scheitert, die Menschen am schwersten lesen können, und wie ein kleinerer Bild-Encoder eine Bewertung direkt auf einem Tablet ermöglichen könnte. Marco Lents setzt diese Forschungslinie in seiner Promotion fort, die der Frage nachgeht, wie künstliche Intelligenz Schülern Rückmeldung zur Leserlichkeit ihrer Handschrift geben kann.
Wir danken Meike Bauer, Erik Schmidt und Lukas Pieger herzlich für ihren Einsatz und ihr Engagement sowie unseren Partnern bei STABILO und dem Schreibmotorik Institut für eine enge und vertrauensvolle Zusammenarbeit. Ihre Arbeiten zeigen, dass eine Abschlussarbeit am xAILab Bamberg Teil einer Publikation in einer internationalen Fachzeitschrift werden kann, und wir laden motivierte Studenten, die an solcher Forschung mitwirken möchten, herzlich ein, sich für eine Abschlussarbeit bei uns zu melden.