Fünf Publikationen, zwei Challenges und eine Auszeichnung: Das xAILab Bamberg auf der MICCAI 2026 in Straßburg
Unsere Beiträge im Überblick
Vertreten wurde unsere Gruppe in Straßburg von den Doktoranden Sebastian Doerrich, Francesco Di Salvo und Shyam Nandan Rai, der Doktorandin Hanh Huyen My Nguyen sowie Professor Christian Ledig. Die Woche begann am Sonntag, dem 27. September, mit zwei Workshop-Vorträgen, einem beim Workshop on Endoluminal Intervention Navigation and Autonomy (EndoLINA) und einem beim Workshop on Uncertainty for Safe Utilization of Machine Learning in Medical Imaging (UNSURE). Am selben Tag vertrat uns Hanh Huyen My Nguyen bei der RARE26 Challenge. Am Montag, dem 28. September, präsentierten wir unser Poster in der Hauptkonferenz. Am letzten Konferenztag, Donnerstag, dem 1. Oktober, folgten zwei weitere Workshop-Beiträge, ein Poster beim Workshop on Efficient Medical AI (EMA4MICCAI) und ein Vortrag beim DEMI, sowie die Bekanntgabe der Ergebnisse der ORena SAVE FOCUS Challenge.
Polypendetektion unter realen klinischen Bedingungen bei EndoLINA
Bei EndoLINA eröffnete Sebastian Doerrich unsere Woche mit einem Vortrag zu "TRUE-Colon: Exposing a Consistent Transfer Asymmetry in Real-Time Polyp Detection". Computergestützte Detektionssysteme für die Darmspiegelung sollen Ärzten helfen, Polypen, die Vorstufen von Darmkrebs, zu finden, die andernfalls übersehen würden. Die meisten dieser Systeme werden auf kuratierten Videoausschnitten entwickelt, die sich auf die Polypen selbst konzentrieren und die langen Abschnitte einer realen Untersuchung auslassen, in denen kein Polyp zu sehen ist. Die Arbeit stellt TRUE-Colon vor, ein standardisiertes Benchmarking-Protokoll, das misst, wie sich ein Detektor in der Praxis verhält: wie genau er Polypen lokalisiert, wie viele Fehlalarme er auslöst, wie schnell er reagiert, sobald ein Polyp erscheint, und wie zuverlässig er ihn weiterhin erkennt. Wir haben vier Echtzeit-Detektoren auf zwei kuratierten Benchmarks und auf 60 vollständigen, ungeschnittenen Darmspiegelungen evaluiert.
Die Ergebnisse zeigen eine deutliche Asymmetrie. Detektoren, die auf kuratierten Ausschnitten trainiert wurden, verloren auf vollständigen Untersuchungen den Großteil ihrer Genauigkeit; bei YOLOv11 sank der Lokalisierungswert (mAP50) von 0,724 auf dem kuratierten SUN-Benchmark auf 0,164 auf vollständigen Untersuchungen. Detektoren, die auf vollständigen Untersuchungen trainiert wurden, behielten dagegen ihre Genauigkeit auch auf kuratierten Ausschnitten bei und erreichten auf SUN mAP50-Werte zwischen 0,705 und 0,717. Wir folgern daraus, dass sowohl Training als auch Evaluation solcher Systeme stärker auf vollständige Untersuchungen ausgerichtet werden sollten.
Die vollständige Abhandlung finden Sie hier.
Die richtige Schichtauswahl für die Out-of-Distribution-Erkennung bei UNSURE
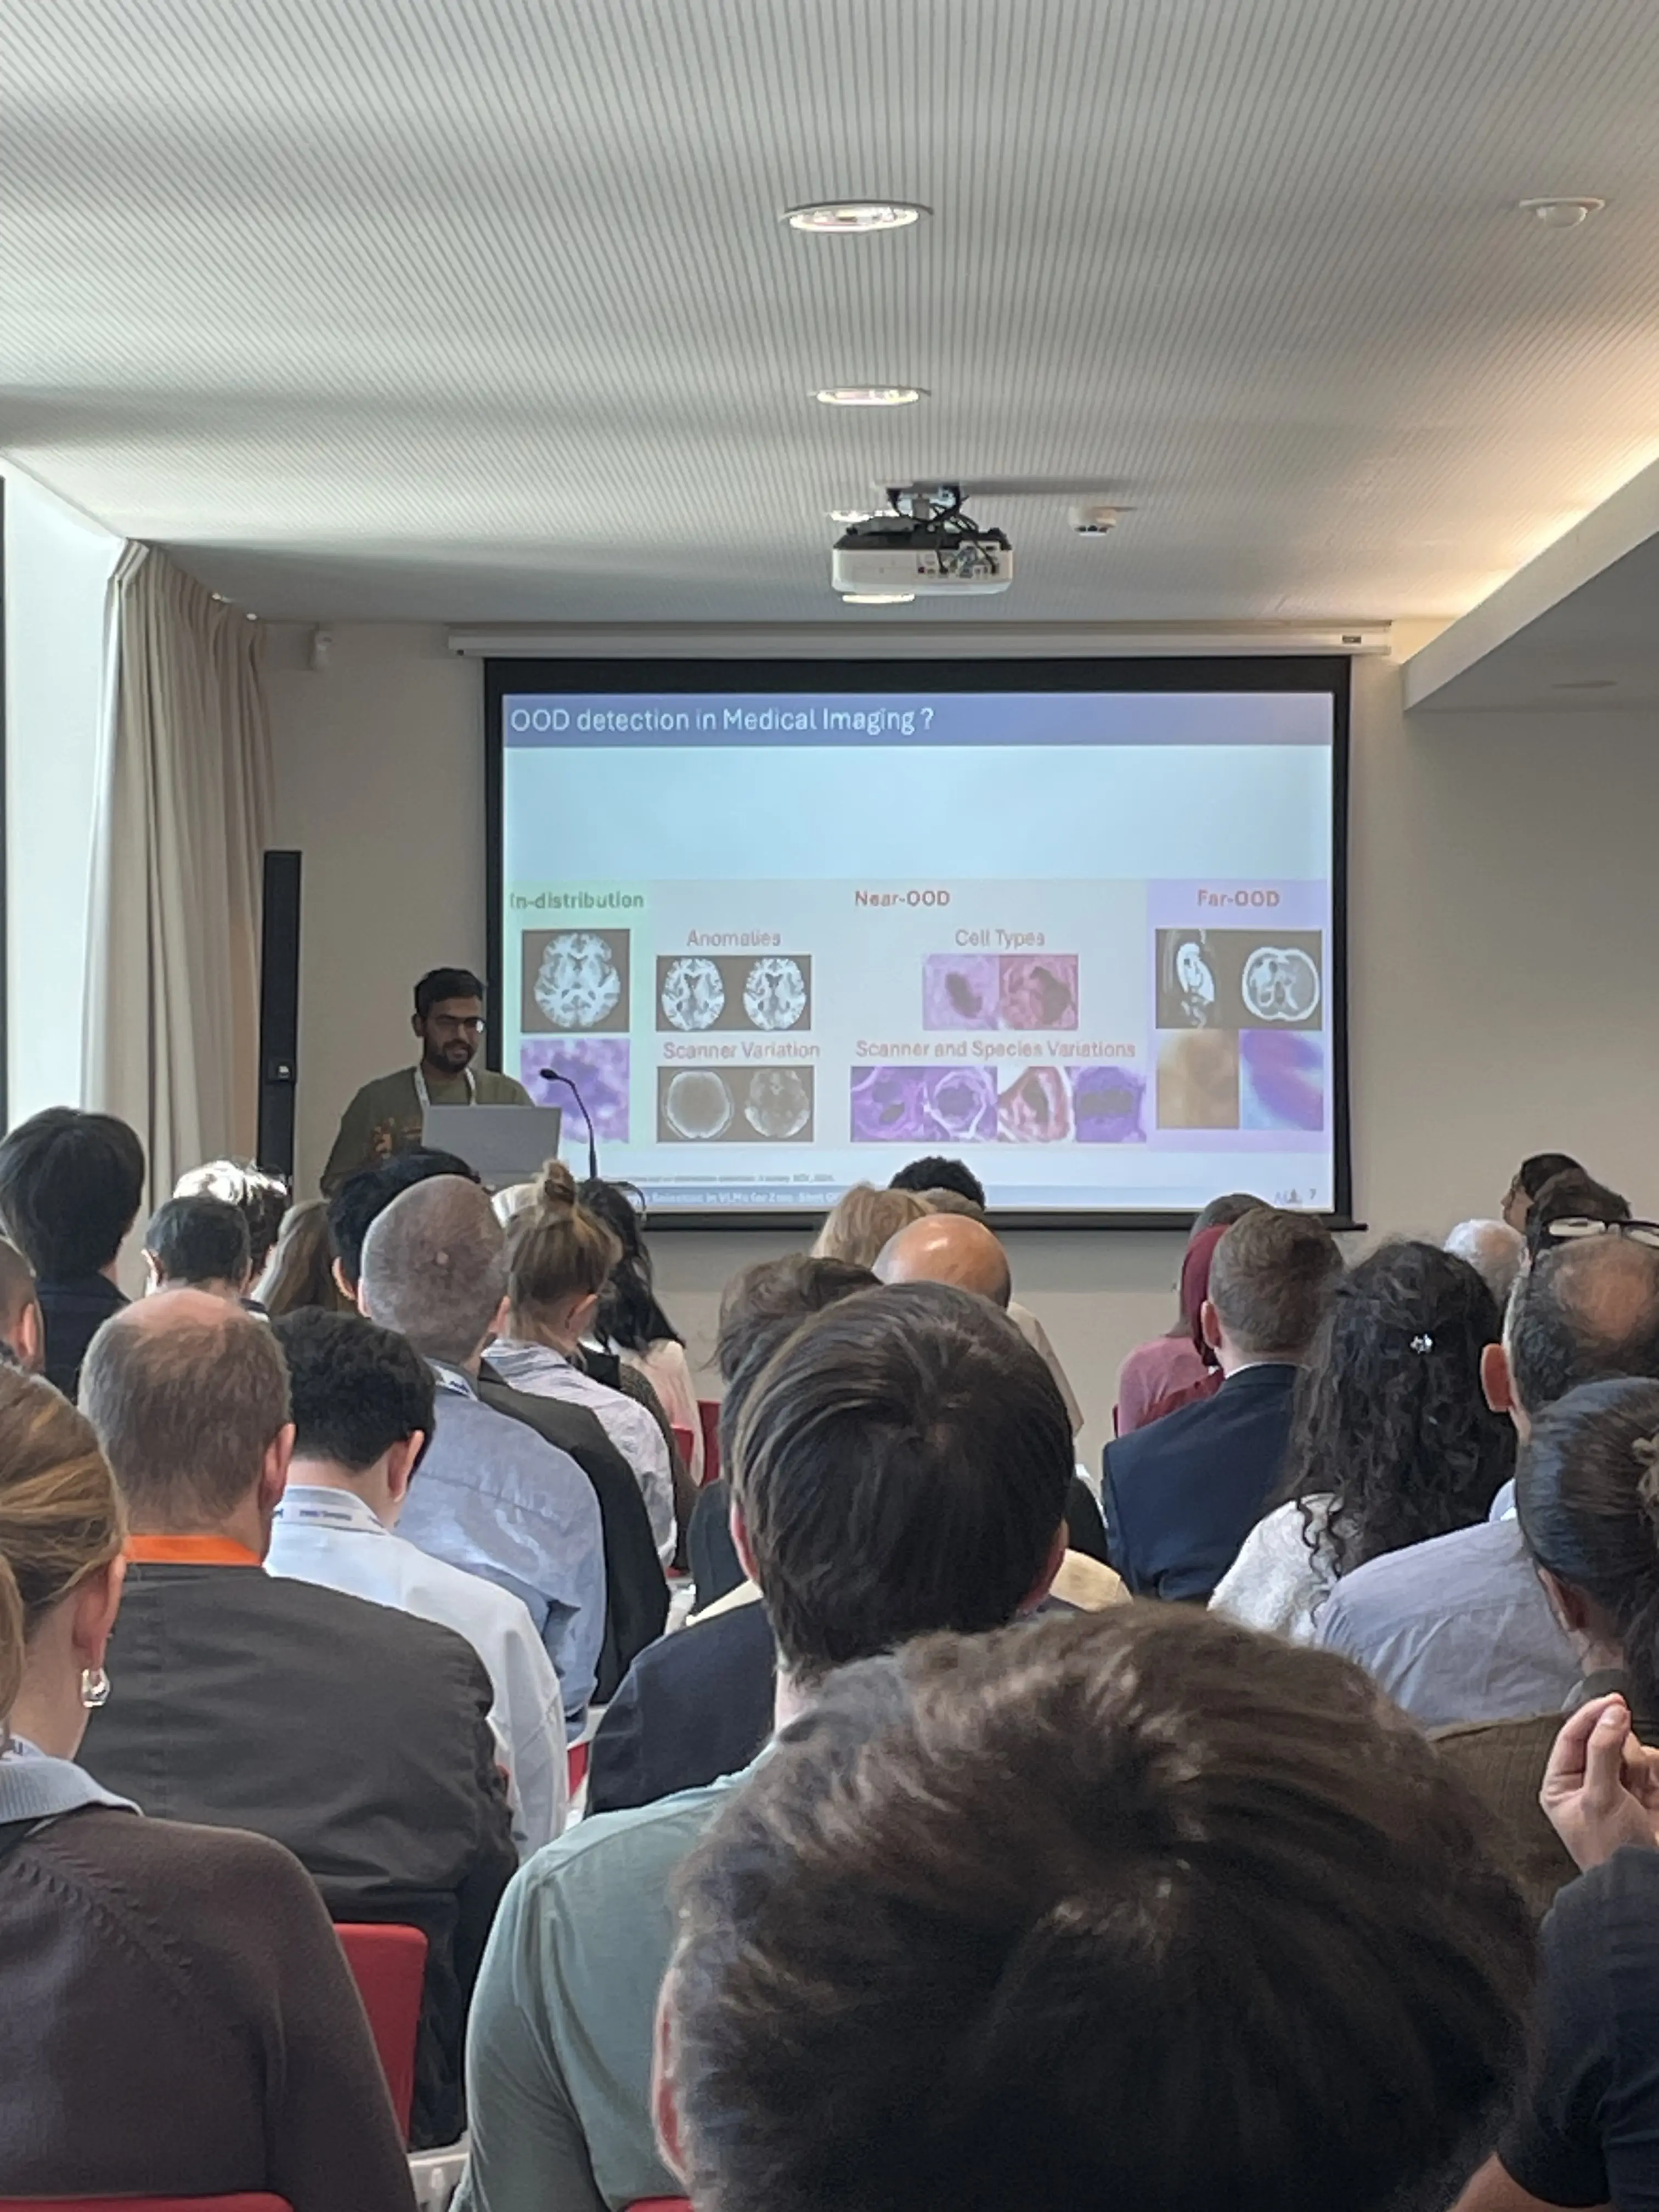
Am selben Tag hielt Shyam Nandan Rai bei UNSURE einen langen Vortrag zu "Layer Selection in VLMs for Zero-Shot OOD Detection via Multi-Resolution Entropy Estimation". Medizinische KI-Systeme müssen erkennen können, wenn sich ein Bild von den Daten unterscheidet, auf denen sie entwickelt wurden, etwa weil es aus einem anderen Krankenhaus, von einem anderen Scanner oder aus einer anderen Patientengruppe stammt. Vision-Language-Modelle können solche Bilder außerhalb der Trainingsverteilung ohne zusätzliches Training markieren, bisherige Methoden nutzen dafür jedoch fast ausschließlich die letzte Schicht des Modells. Die Arbeit zeigt, dass Zwischenschichten ergänzende Informationen enthalten und die geeignetste Tiefe von der Bildmodalität abhängt: Verschiebungen in der Histopathologie werden am besten in frühen Schichten erkannt, Verschiebungen in der Hirn-MRT in mittleren bis späten Schichten. Bisherige Ansätze wählen die Schichten mit einer Entropieschätzung auf einer einzigen Auflösung aus, und die Arbeit zeigt, dass deren Detektionsleistung (AUROC) je nach dieser einen Einstellung um bis zu 19,3 Prozentpunkte schwankt. Die vorgeschlagene Methode kombiniert Entropieschätzungen über mehrere Auflösungen, wodurch die Schichtauswahl stabil bleibt und ausschließlich Daten der Trainingsverteilung benötigt werden. Auf Histopathologie- und Hirn-MRT-Benchmarks mit zwei medizinischen Vision-Language-Modellen erzielte sie in nahezu allen Konfigurationen die besten oder vergleichbare Ergebnisse.
Die vollständige Abhandlung finden Sie hier.
Varianzbewusste Out-of-Distribution-Erkennung in der Hauptkonferenz
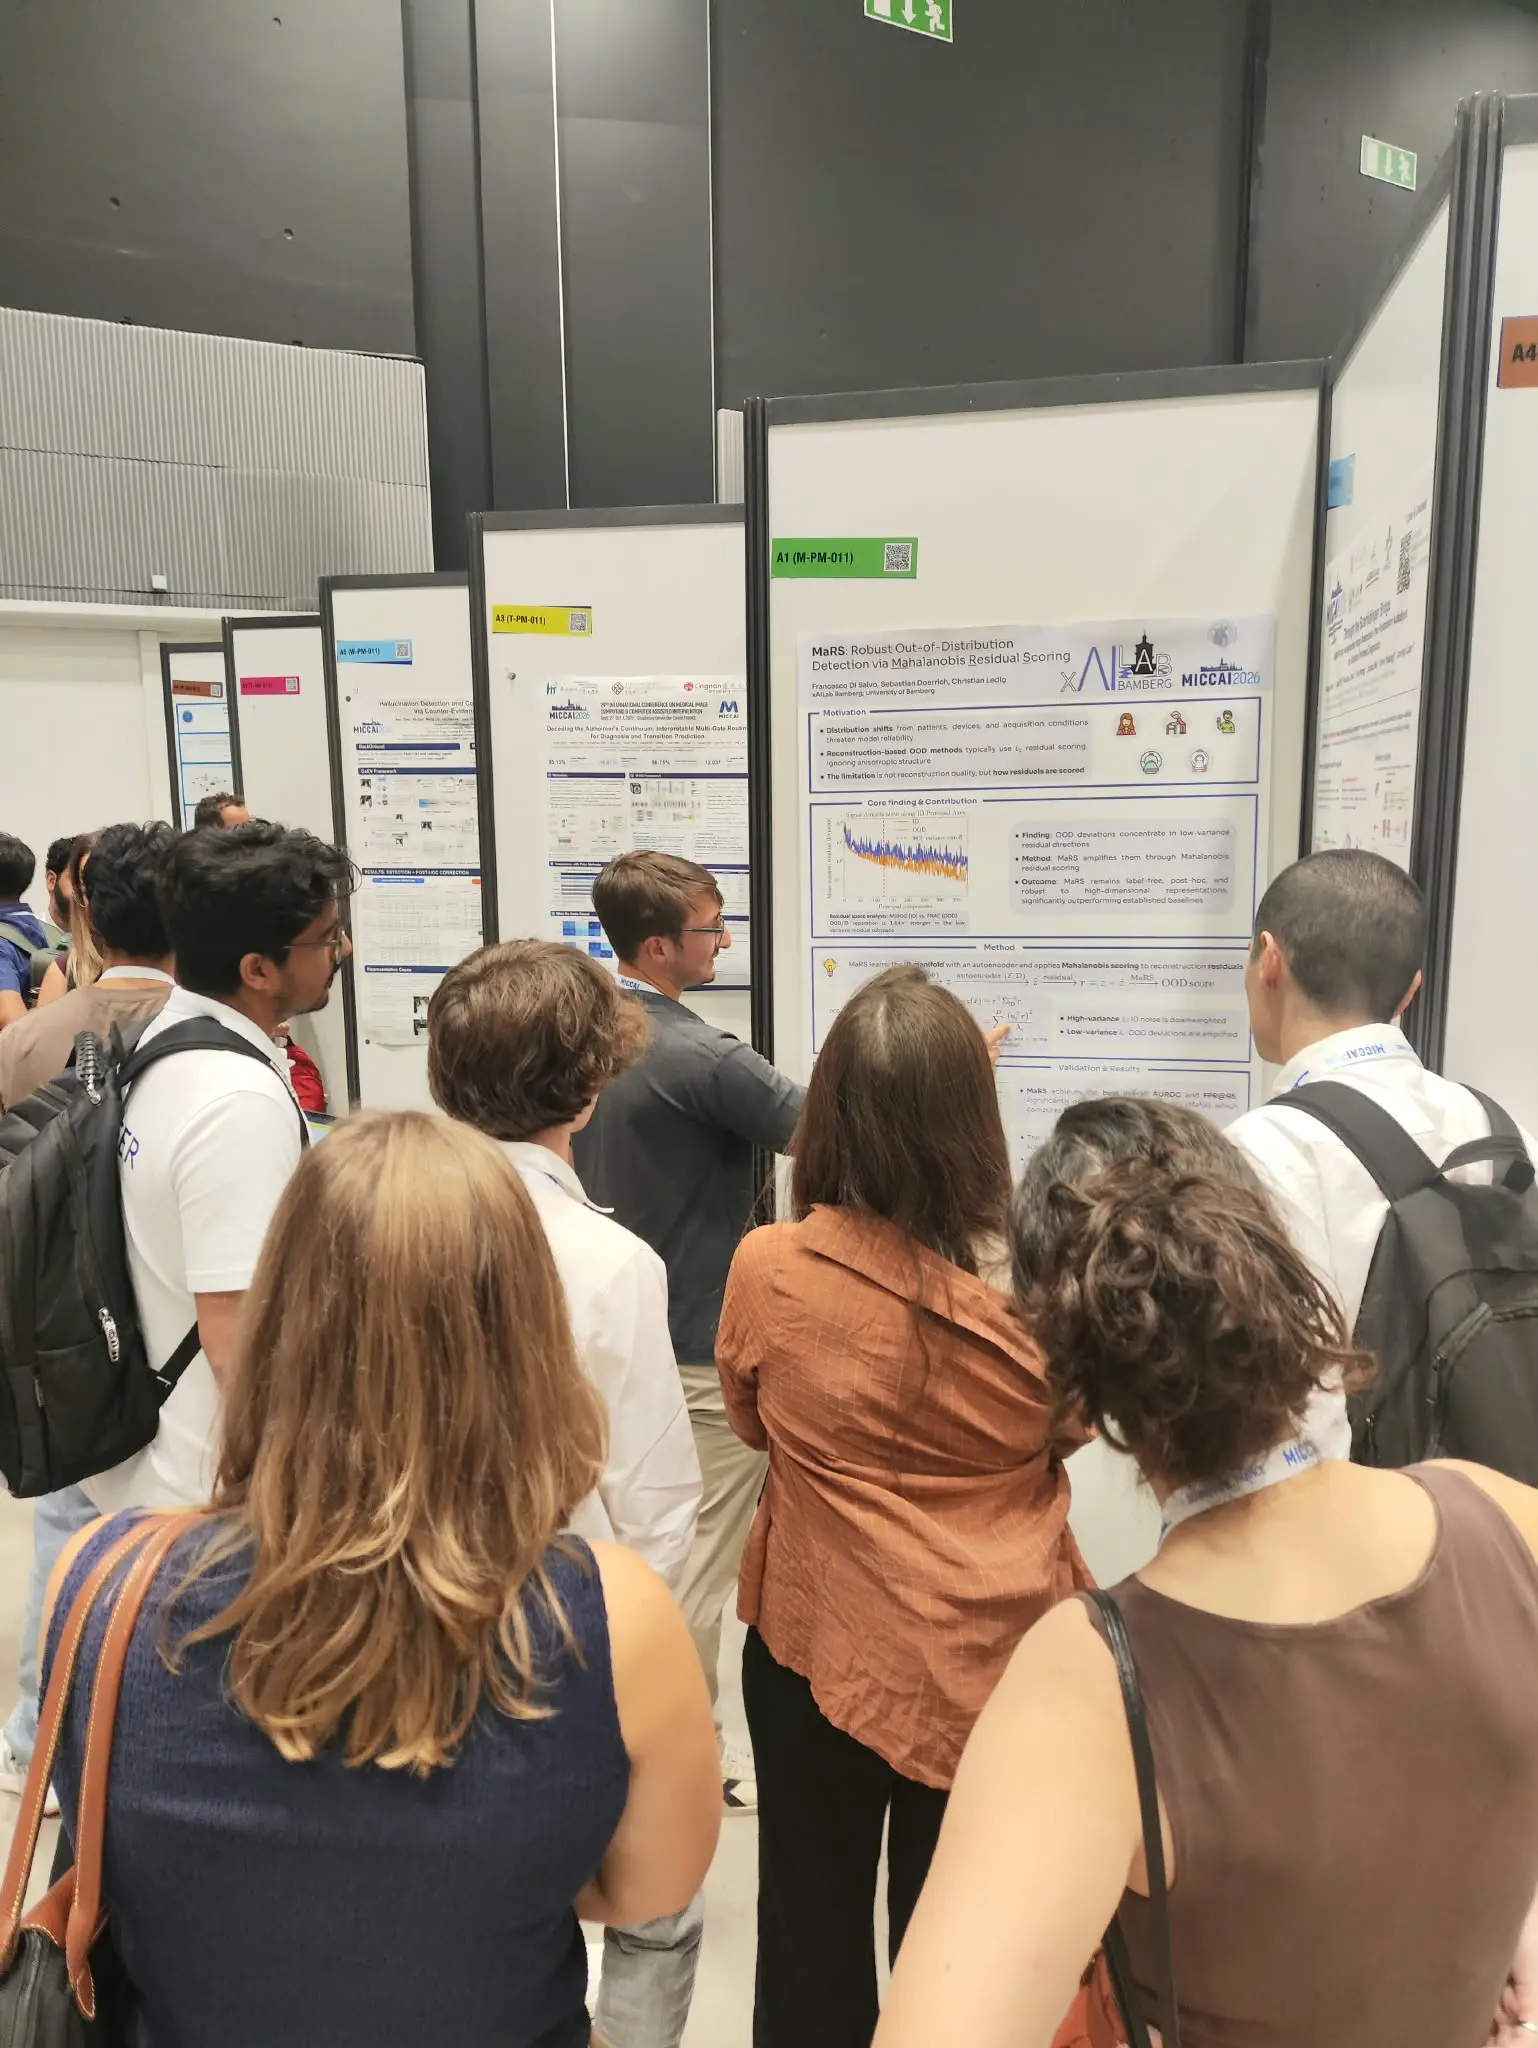
Am 28. September präsentierte Francesco Di Salvo unser Poster in der Hauptkonferenz zu "MaRS: Robust Out-of-Distribution Detection via Mahalanobis Residual Scoring". Bilder zu erkennen, die außerhalb der Trainingsverteilung eines Modells liegen, ist für dessen sicheren Einsatz in der Klinik unerlässlich. Eine Gruppe von Methoden lernt, die Merkmale bekannter Bilder zu rekonstruieren, und markiert ein Bild als unbekannt, wenn sein Rekonstruktionsfehler groß ist. Solche Methoden lieferten bislang uneinheitliche Ergebnisse, und die Arbeit führt dies darauf zurück, wie der Rekonstruktionsfehler zu einem einzelnen Wert zusammengefasst wird: Der übliche Ansatz gewichtet alle Richtungen des Fehlers gleich, obwohl die Fehler bekannter Bilder in manchen Richtungen deutlich stärker schwanken als in anderen. MaRS lernt die Struktur bekannter Bilder mit einem leichtgewichtigen Autoencoder auf Basis eines eingefrorenen Foundation Modells und bewertet den Rekonstruktionsfehler mit einer Mahalanobis-Distanz, die diese ungleichmäßige Varianz berücksichtigt. Über drei Bildmodalitäten und mehrere Arten von Verteilungsverschiebungen hinweg erzielte MaRS die beste durchschnittliche AUROC aller verglichenen Methoden (86,01 gegenüber 85,34 für die stärkste Vergleichsmethode) sowie die niedrigste durchschnittliche Falsch-Positiv-Rate bei 95 Prozent Richtig-Positiv-Rate (42,72 gegenüber 43,59), eine statistisch signifikante Verbesserung gegenüber dieser Vergleichsmethode. Die Methode benötigt keine Labels und kann nach dem Training zu einem bestehenden Modell hinzugefügt werden.
Die vollständige Abhandlung finden Sie hier.
Ein Modell für viele Klassifikationsaufgaben bei EMA4MICCAI
Am 1. Oktober präsentierte Sebastian Doerrich beim 2nd MICCAI Workshop on Efficient Medical AI das Poster "MoPET: Parameter-Efficient Mixture-of-Experts for Unified Medical Image Classification". Große Foundation Modelle werden üblicherweise an eine medizinische Aufgabe angepasst, indem nur eine kleine Menge zusätzlicher Parameter trainiert wird, während das ursprüngliche Netzwerk eingefroren bleibt. Dieses parametereffiziente Fine-Tuning funktioniert auch mit wenigen Daten gut, erfordert jedoch für jede Aufgabe einen eigenen Adapter, und das bloße Zusammenführen der Adapter in einem Netzwerk kann dazu führen, dass sich die Aufgaben gegenseitig stören. MoPET kombiniert mehrere kleine Adapter, sogenannte Experten, innerhalb eines eingefrorenen Foundation Modells und lernt einen Router, der jedes Bild nur durch wenige von ihnen leitet. So können verwandte Aufgaben Kapazität teilen, während konkurrierende Aufgaben getrennt bleiben. Auf dem MedMNIST-Benchmark bestätigt die Arbeit zunächst, dass parametereffizientes Fine-Tuning das Training des gesamten Netzwerks übertrifft und die durchschnittliche Genauigkeit von 86,50 auf 88,97 Prozent steigert. Ein einziges MoPET-Modell, trainiert auf vier heterogenen Datensätzen, erreichte anschließend eine durchschnittliche Genauigkeit von 93,46 Prozent, verglichen mit 92,83 Prozent für die besten separat trainierten Adapter. Das gemeinsame Training mit zusätzlichen Datensätzen verbesserte zudem die durchschnittliche Genauigkeit auf datenarmen Zielaufgaben von 81,58 auf 83,58 Prozent.
Die vollständige Abhandlung finden Sie hier.
Best Paper Award Runner-Up für statistischen Farbabgleich bei DEMI
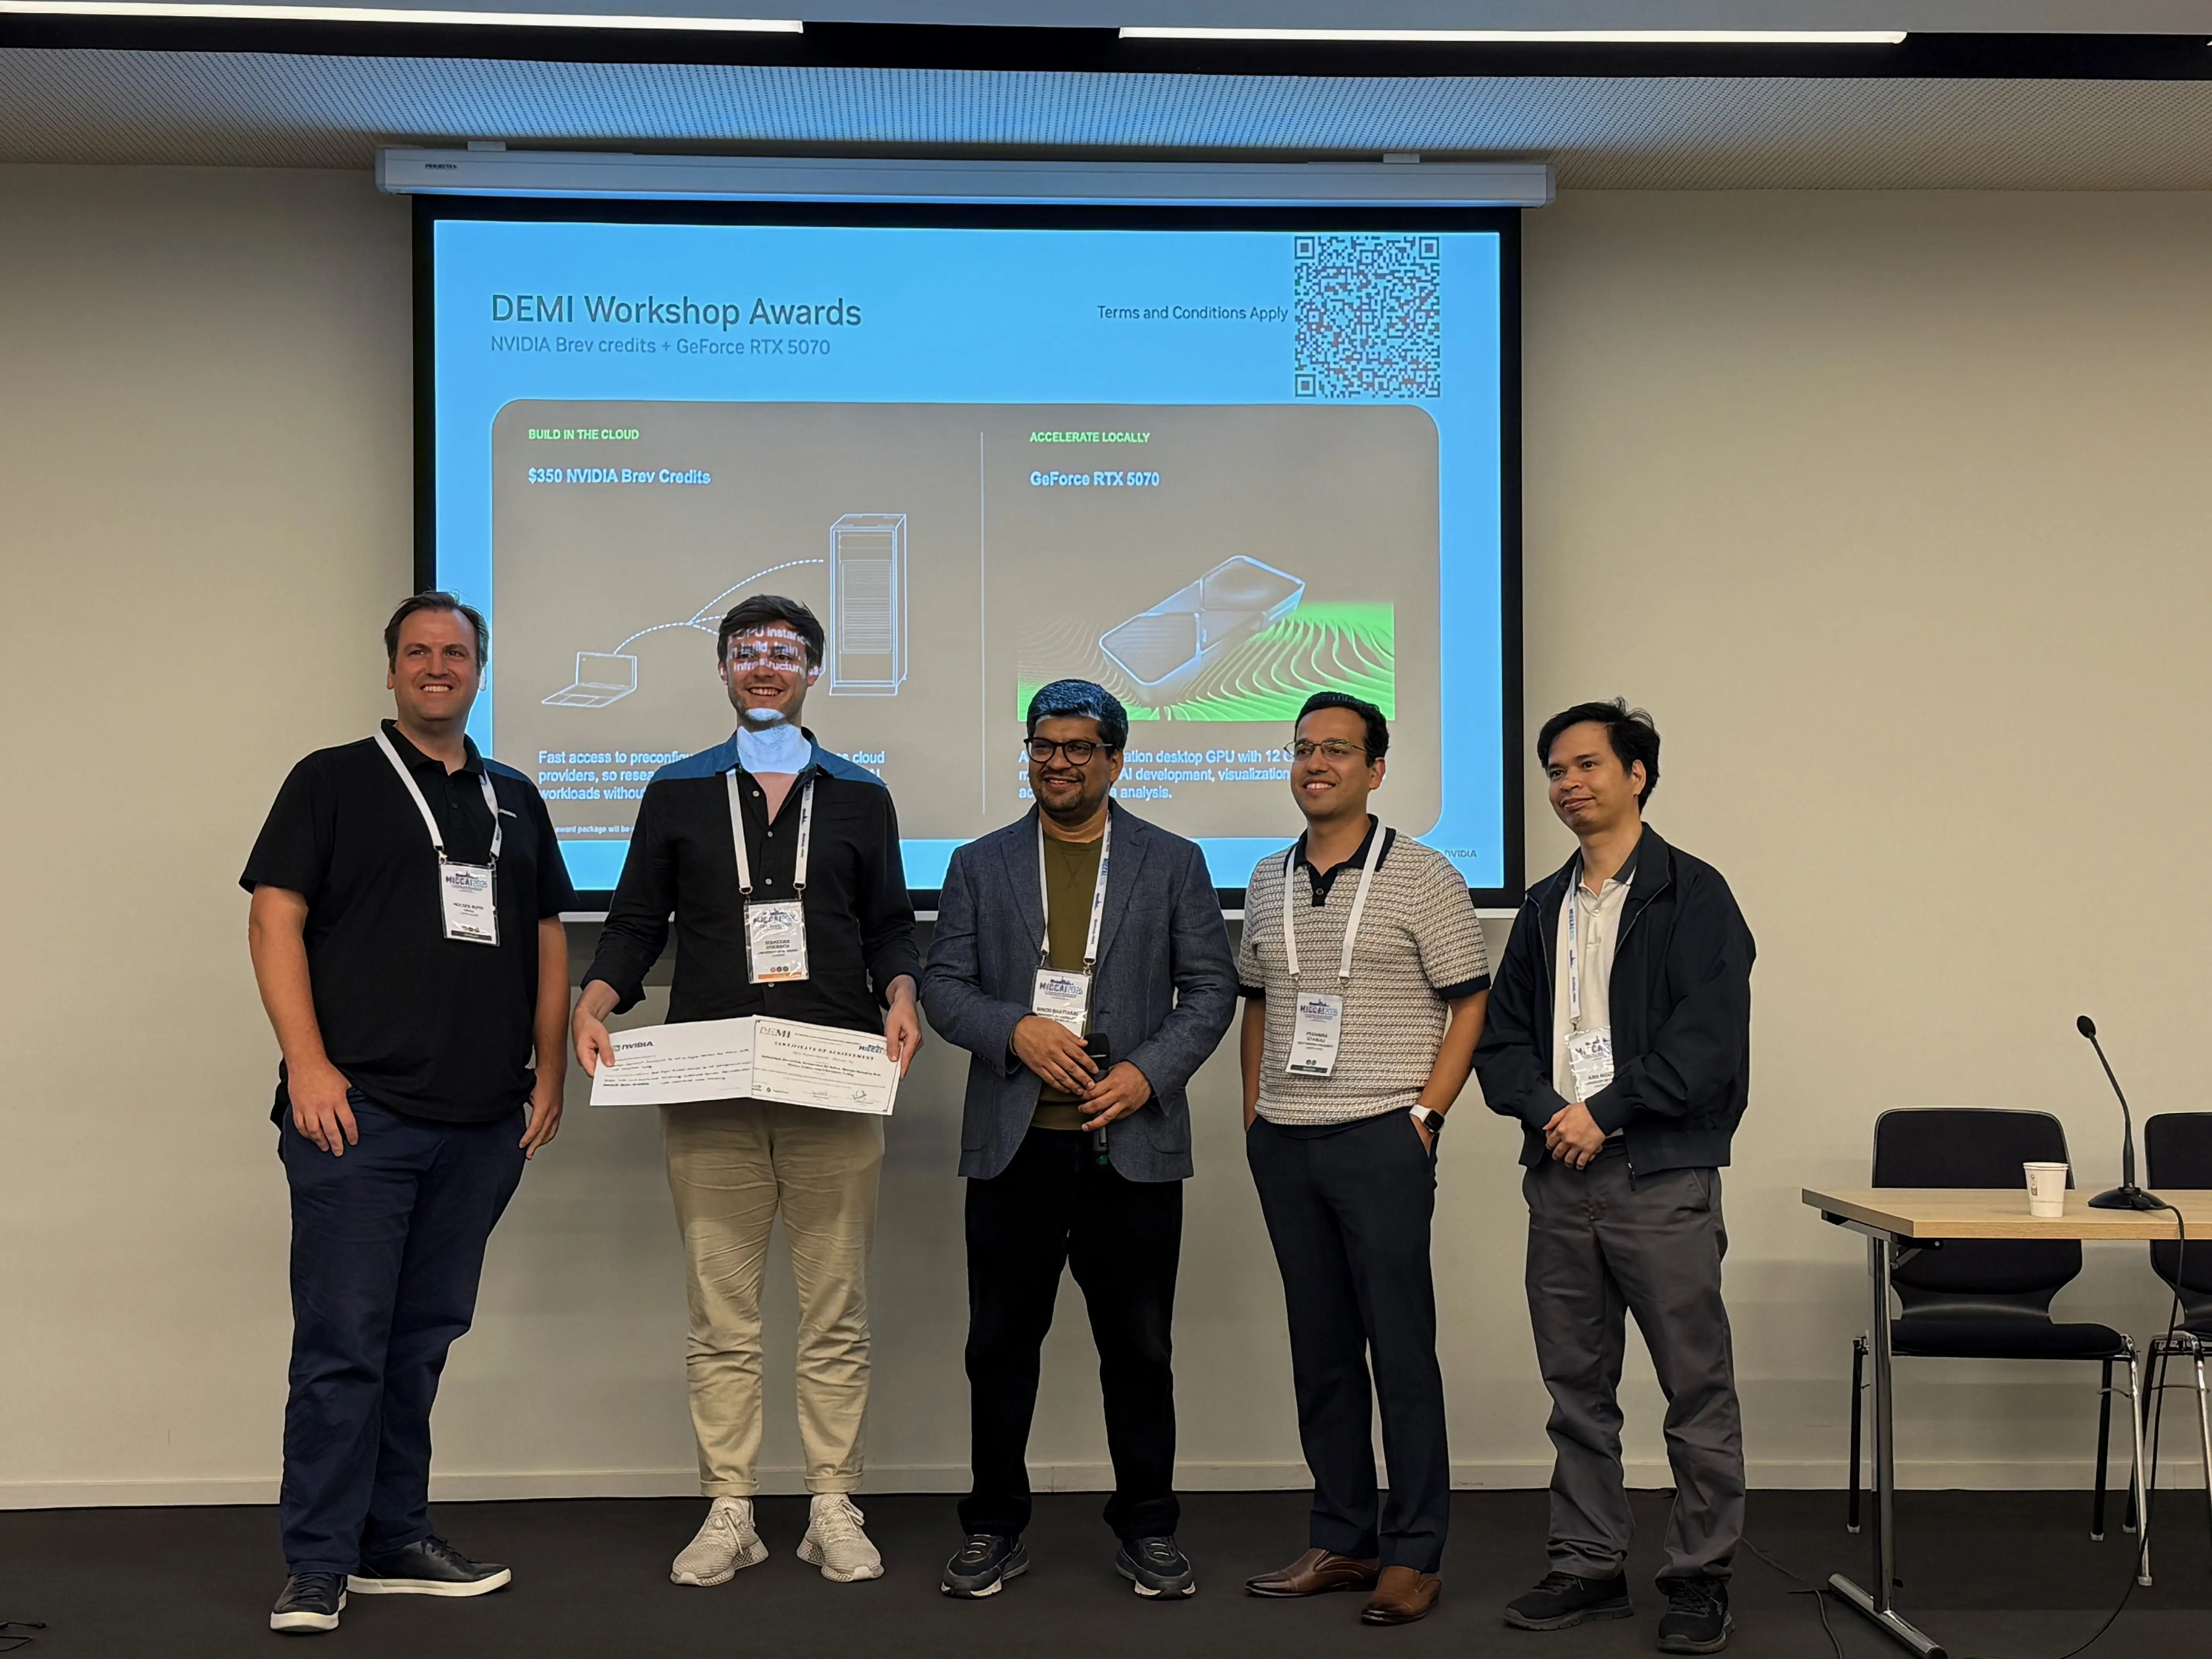
Den Abschluss unserer Woche bildete ein Vortrag von Sebastian Doerrich beim 4th Workshop on Data Engineering in Medical Imaging zu "Simple, Safe, and Overlooked: Reclaiming Sustainable Domain Generalization with Statistical Color Matching". Medizinische Bildklassifikatoren versagen nach dem Einsatz häufig, weil Bilder von einem neuen Scanner, aus einem anderen Färbeprotokoll oder aus einer anderen Patientengruppe farblich anders aussehen als die Trainingsdaten. Solche Variationen während des Trainings zu erzeugen ist ein gängiger Lösungsansatz, doch einfache Farbveränderungen bieten zu wenig Vielfalt, während tiefe generative Modelle für den Stiltransfer rechenintensiv sind und anatomische Strukturen verändern oder hinzuerfinden können. Die Arbeit greift den klassischen statistischen Farbabgleich wieder auf und entwickelt daraus Colorist, eine Datenaugmentierung, die Mittelwert und Standardabweichung jedes Farbkanals von einem Trainingsbild auf ein anderes überträgt. Colorist benötigt weder Training noch ein neuronales Netz, und da ausschließlich Farbwerte verändert werden, bleibt die Anatomie des Bildes vollständig erhalten. Im Vergleich mit dreizehn tiefen Stiltransfer-Modellen bewahrte Colorist die Bildstruktur am besten und glich die Farben am genauesten an. Über 12 Datensätze innerhalb der Trainingsverteilung und 7 verschobene Datensätze außerhalb davon, aus Histopathologie, Blutzellbildern, Dermatologie und Netzhautbildgebung, verbesserte Colorist die Balanced Accuracy um bis zu 9 Prozentpunkte gegenüber führenden Methoden der Domänengeneralisierung und um 13 Prozentpunkte gegenüber einem Training ohne Augmentierung. Auf derselben Hardware war Colorist schneller als jede verglichene Stiltransfer-Methode und verbrauchte pro Bild zwischen 5,4- und 10.601-mal weniger Energie. Die Organisatoren des DEMI würdigten die Arbeit mit dem Best Paper Award Runner-Up.
Die vollständige Abhandlung finden Sie hier.
Zwei Challenge-Beiträge: RARE26 und ORena SAVE FOCUS
Über die Publikationen hinaus nahm unsere Gruppe an zwei MICCAI-Challenges teil. Hanh Huyen My Nguyen trat bei RARE26 an, der Challenge zur Recognition of Abnormalities in low prevalence cancer, die Teil der EndoVis-Challenge-Reihe ist. Sie befasst sich mit der Erkennung von frühem Krebs bei Patienten mit Barrett-Ösophagus während der routinemäßigen endoskopischen Überwachung, einem Szenario, in dem frühe Neoplasien typischerweise bei weniger als 1 Prozent der Patienten gefunden werden und die wenigen relevanten Bilder leicht in der Masse unauffälliger Befunde untergehen. Unsere Methode, MILES, passt ein gastrointestinales Foundation Modell an, das auf Endoskopiebildern aus mehreren Zentren vortrainiert wurde, und untersucht jedes Bild Region für Region, sodass auch kleine, lokal begrenzte Veränderungen in einem ansonsten unauffälligen Bild erkannt werden können. Mit diesem Ansatz belegte unser Team den 6. Platz von 34 Teams.
Im FRAME-Track der ORena SAVE FOCUS Challenge befasste sich Shyam Nandan Rai mit der Frage, ob Vision-Language-Modelle klinisch relevante Fragen zu einem einzelnen laparoskopischen Bild beantworten können. Die Fragen konzentrieren sich auf Fremdkörper wie Tupfer, Nadeln und Clips, die nach einem minimalinvasiven Eingriff nicht im Körper des Patienten verbleiben dürfen. Unser Ansatz kombiniert innerhalb eines Vision-Language-Modells einen allgemeinen und einen auf Chirurgie spezialisierten Bild-Encoder. Er belegte den 16. Platz von 26 Teams und übertraf die von den Organisatoren bereitgestellte Vergleichsmethode. Die Ergebnisse der Challenge wurden am 1. Oktober auf der MICCAI bekanntgegeben.
Wissenschaft, Networking und die Erfahrung in Straßburg
Die MICCAI 2026 fand im Strasbourg Convention Center statt. Die Stadt war ursprünglich bereits als Austragungsort der MICCAI 2021 ausgewählt worden, als die Pandemie die Konferenz in den Online-Raum verlagerte, und sprang in diesem Jahr erneut ein, nachdem die Konferenz aus Abu Dhabi verlegt werden musste. Mit einer Rekordzahl an Einreichungen, einer Annahmequote von etwa 27 Prozent und mehr als 3.900 Gutachtern aus 71 Ländern spiegelte die Konferenz das starke Wachstum des Fachgebiets wider. Viele der Themen, denen wir in der Hauptkonferenz und den Workshops begegneten, von Robustheit unter Verteilungsverschiebungen und der Erkennung von Bildern außerhalb der Trainingsverteilung bis hin zur effizienten Anpassung von Foundation Modellen und der sorgfältigen Evaluation klinischer KI-Systeme, decken sich eng mit den Forschungsschwerpunkten unserer Gruppe. Die MICCAI ist zudem der Ort, an dem wir zuverlässig viele unserer Freunde und Kooperationspartner treffen, und Straßburg bildete keine Ausnahme: Wir freuten uns sehr, Kollegen von der FAU Erlangen-Nürnberg, dem Imperial College London, der Technischen Universität München und vielen weiteren Einrichtungen wiederzusehen, und führten mit ihnen über die ganze Woche hinweg großartige Gespräche. Auch die Gastgeberstadt selbst blickt auf eine lange wissenschaftliche Tradition zurück: Die Universität Straßburg, entstanden im Herzen der Grande Île, lehrt seit 1538, und auch Louis Pasteur unterrichtete hier.
Ausblick
Mit fünf Publikationen, drei Vorträgen, zwei Challenge-Beiträgen und einer Auszeichnung war die MICCAI 2026 für unsere Gruppe eine Woche voller Austausch. Besonders stolz sind wir darauf, dass zwei der diesjährigen Publikationen aus Masterarbeiten an unserem Lehrstuhl hervorgegangen sind. Die Masterstudenten Andreas Schwab und Daniel Würtinger haben ihre Abschlussarbeiten in TRUE-Colon beziehungsweise MoPET eingebracht und sind jeweils gleichberechtigte Erstautoren der daraus entstandenen Publikation. Wir danken beiden herzlich für ihren Einsatz und ihr Engagement. Ihre Arbeiten zeigen, dass eine Abschlussarbeit am xAILab Bamberg zu einer Publikation auf einer der führenden Konferenzen der medizinischen Bildanalyse führen kann, und wir laden motivierte Studenten, die an solcher Forschung mitwirken möchten, herzlich ein, sich für eine Abschlussarbeit bei uns zu melden. Die Fragen, die an unseren Postern und nach unseren Vorträgen aufkamen, werden die nächsten Schritte dieser Projekte prägen. Wir kehren mit wertvollem Feedback von der MICCAI 2026 zurück und freuen uns darauf, die nächsten Herausforderungen anzugehen.